Common Crawl on voittoa tavoittelemattoman Common Crawl Foundation -organisaation ylläpitämä avoin verkkosivustojen aineistoarkisto. Se kerää automaattisesti verkkosivujen sisältöä ja julkaisee keräämänsä aineiston maksutta tutkijoiden, yritysten ja muiden käyttäjien hyödynnettäväksi. Common Crawlin aineistoa käytetään muun muassa tekoälymallien kouluttamiseen, verkkosivustojen ja linkkiverkostojen tutkimiseen sekä internetin sisällön analysointiin.
Common Crawl on yksi maailman merkittävimmistä avoimista verkkodatan lähteistä. Sen arkisto sisältää yli 10 petatavua aineistoa, ja uusia verkkosivujen indeksointiajoja julkaistaan yleensä kuukausittain. Yksittäinen keräyskierros kattaa tyypillisesti yli kaksi miljardia verkkosivua.
Hakukoneoptimoinnin (SEO) ja tekoälyoptimoinnin (GEO) näkökulmasta Common Crawl on erityisen kiinnostava, koska sen keräämää verkkosisältöä on hyödynnetty useiden suurten kielimallien koulutusaineistoissa. Siksi sillä, millaista tietoa yrityksestä verkossa julkaistaan ja miten helposti tämä tieto on koneellisesti löydettävissä, voi olla merkitystä myös tekoälyjärjestelmien muodostamalle käsitykselle yrityksestä.
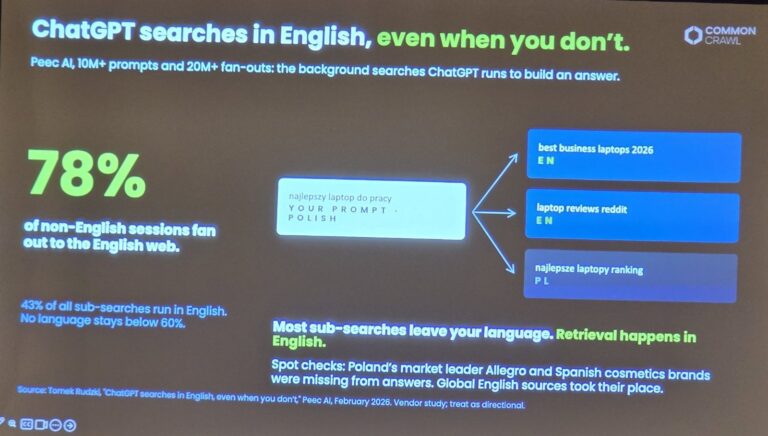
Lue myös englanninkielen merkityksestä Common Crawlin näkökulmasta: Tekoäly hakee taustalla englanniksi – tarvitseeko suomalainen yritys englanninkielisen sivuston?
Mikä Common Crawlin tarkoitus on?
Internet sisältää valtavan määrän tietoa, mutta sen järjestelmällinen kerääminen ja analysointi on teknisesti haastavaa ja kallista. Suurilla hakukoneyhtiöillä on omat verkkosivujen indeksointijärjestelmänsä, mutta niiden keräämä raakadata ei yleensä ole avoimesti muiden käytettävissä.
Common Crawl perustettiin ratkaisemaan tätä ongelmaa.
Organisaation tavoitteena on demokratisoida verkkodatan saatavuus. Sen sijaan, että vain suurilla teknologiayhtiöillä olisi mahdollisuus hyödyntää laajoja verkkosivujen aineistoja, Common Crawl tarjoaa vastaavanlaista dataa myös yliopistoille, tutkijoille, pienemmille teknologiayrityksille ja itsenäisille kehittäjille.
Common Crawl Foundation perustettiin vuonna 2007, ja verkkosivujen kerääminen alkoi vuonna 2008. Organisaation perustaja on Gil Elbaz, joka tunnetaan myös Googlen vuonna 2003 ostaman Applied Semantics -yrityksen perustajiin kuuluneena yrittäjänä.
Vuosien aikana Common Crawlista on kehittynyt tärkeä osa internetin tutkimusinfrastruktuuria. Sen aineistoja on käytetty tuhansissa tutkimuksissa ja monenlaisissa kaupallisissa sovelluksissa.
Erityisen merkittäväksi Common Crawl nousi generatiivisen tekoälyn kehityksen myötä. Suurten kielimallien kouluttamiseen tarvitaan valtavia määriä tekstiä, ja avoin verkkosivuaineisto tarjoaa tähän yhden keskeisen tietolähteen.
Miten Common Crawl toimii?
Common Crawlin toiminta perustuu verkkosivujen automaattiseen läpikäyntiin eli crawlaamiseen. Perusperiaate on samankaltainen kuin hakukoneiden käyttämissä verkkoroboteissa.
Common Crawl käyttää verkkosivujen keräämiseen CCBot-nimistä verkkorobottia. Se vierailee verkkosivuilla, hakee niiden sisältöä ja tallentaa kerättyä aineistoa myöhempää käsittelyä varten.
Prosessi voidaan jakaa viiteen päävaiheeseen.
1. Verkkosivujen löytäminen
Common Crawlin järjestelmä tarvitsee lähtökohtia, joiden perusteella se löytää kerättäviä verkkosivuja.
Verkkosivujen osoitteita voidaan löytää esimerkiksi aikaisemmista keräysaineistoista ja sivujen sisältämistä hyperlinkeistä. Common Crawl hyödyntää myös erilaisia lähdeaineistoja verkkosivujen löytämisen ja keräyskattavuuden parantamiseksi.
Kaikkia internetin verkkosivuja ei kuitenkaan voida käydä läpi. Kerättävät sivut on valittava käytettävissä olevien resurssien, keräysstrategian ja teknisten rajoitusten perusteella.
2. Verkkosivujen lataaminen
Kun verkkorobotti on löytänyt sopivan URL-osoitteen, se yrittää hakea sivun sisällön verkkopalvelimelta.
Keräyksen yhteydessä voidaan tallentaa esimerkiksi sivun HTML-sisältöä, HTTP-vastauksen tietoja ja muita teknisiä metatietoja.
CCBot ei kuitenkaan toimi kaikilta osin samalla tavalla kuin tavallinen verkkoselain. Esimerkiksi JavaScriptillä vasta selaimessa muodostuva sisältö ei välttämättä tallennu aineistoon samalla tavalla kuin palvelimelta suoraan palautettava HTML.
Tämä on tärkeää erityisesti JavaScript-pohjaisten verkkosivustojen kannalta.
3. Sisällön ja metatietojen tallentaminen
Kerätty aineisto tallennetaan verkkosivujen arkistointiin tarkoitettuihin tiedostomuotoihin.
Common Crawl säilyttää sekä varsinaista kerättyä sisältöä että siitä johdettuja tietoja. Näin aineistoa voidaan käyttää erilaisiin tarkoituksiin ilman, että jokaisen käyttäjän tarvitsee käsitellä kaikkea raakadataa.
Esimerkiksi tekstianalyysiä varten voidaan hyödyntää verkkosivuilta poimittua tekstiä, kun taas linkkiverkoston tutkimiseen voidaan käyttää sivujen sisältämiä hyperlinkkejä.
4. Aineiston julkaiseminen
Common Crawl julkaisee keräysaineistonsa avoimesti, yleensä noin kerran kuukaudessa.
Aineistot ovat saatavilla Amazon Web Services -pilvipalvelun kautta. Niitä voidaan käsitellä pilviympäristössä tai ladata omaan käyttöön.
Käytännössä aineistot ovat niin suuria, ettei kokonaisen keräyskierroksen lataaminen tavalliselle tietokoneelle ole useinkaan tarkoituksenmukaista.
5. Aineiston jatkokäsittely
Common Crawl ei itse päätä, miten kaikki sen julkaisema sisältö lopulta hyödynnetään.
Tutkijat ja yritykset voivat esimerkiksi suodattaa aineistosta tiettyjä kieliä, aiheita, verkkotunnuksia tai sisältötyyppejä.
Tekoälymallien kehittäjät voivat puolestaan käsitellä aineistoa poistamalla päällekkäisyyksiä, roskasisältöä ja muita koulutukseen soveltumattomia osia.
On tärkeää ymmärtää, että Common Crawlin keräämä raakadata ja tekoälymallin lopullinen koulutusaineisto eivät ole sama asia. Niiden välissä voi olla useita laadunvalvonnan, suodatuksen ja aineiston painottamisen vaiheita.
Kuinka suuri Common Crawl on?
Common Crawl kuuluu maailman suurimpiin julkisesti saatavilla oleviin verkkosivujen aineistoarkistoihin.
Organisaation ilmoittamien tietojen mukaan sen arkistossa on yli 10 petatavua dataa. Yksi petatavu vastaa noin miljoonaa gigatavua.
Yksittäiset keräyskierrokset ovat myös huomattavan suuria.
Esimerkiksi lokakuussa 2026 julkaistu keräysaineisto sisälsi seuraavat määrät:
| Mittari | Lokakuun 2026 keräys |
|---|---|
| Kerättyjä verkkosivuja | 2,16 miljardia |
| Verkkopalvelinten isäntänimiä | 41,4 miljoonaa |
| Rekisteröityjä verkkotunnuksia | 34,3 miljoonaa |
| Aiemmin keräämättömiä URL-osoitteita | 830,1 miljoonaa |
| Pakkaamaton aineisto | 371,19 TiB |
Luvut kuvaavat yhden keräyskierroksen laajuutta, eivät koko internetin kokoa.
Common Crawl ei myöskään sisällä kaikkia maailman verkkosivuja. Sen aineisto on otos verkon sisällöstä, ja eri sivustojen kattavuus voi vaihdella huomattavasti.
Suosittuja ja paljon linkitettyjä sivustoja voidaan löytää helpommin kuin pieniä, uusia tai muusta verkosta erillään olevia verkkosivustoja.
Myös kieli, verkkosivuston tekninen toteutus ja sisällön saavutettavuus voivat vaikuttaa siihen, mitä aineistoon päätyy.
Mitä tietoja Common Crawl kerää verkkosivuilta?
Common Crawlin aineisto sisältää huomattavasti muutakin kuin verkkosivuilta kopioitua tekstiä.
Keskeisiä tietotyyppejä ovat verkkosivujen sisältö, tekniset metatiedot ja sivujen väliset linkitykset.
WARC – verkkosivujen raakadata
WARC eli Web ARChive on verkkosisällön arkistointiin kehitetty tiedostomuoto.
Common Crawlin WARC-tiedostot sisältävät verkkokeräyksen varsinaisia tallenteita, kuten HTTP-vastauksia ja niiden sisältöä.
WARC-aineistosta voidaan tutkia esimerkiksi verkkosivun HTML-rakennetta, otsikoita, linkkejä ja muita sivulla olleita tietoja.
WARC on erityisen hyödyllinen silloin, kun tarvitaan mahdollisimman tarkkaa tietoa siitä, millaisen vastauksen verkkopalvelin antoi keräyshetkellä.
WAT – verkkosivujen metatiedot
WAT-tiedostot sisältävät WARC-aineistosta johdettuja metatietoja.
Niistä voidaan löytää esimerkiksi sivujen otsikkotietoja ja hyperlinkkeihin liittyviä tietoja.
WAT on hyödyllinen verkkosivustojen rakenteiden ja linkitysten analysoinnissa, koska kaikkea alkuperäistä HTML-sisältöä ei tarvitse käsitellä erikseen.
WET – verkkosivuilta poimittu teksti
WET-tiedostot sisältävät verkkosivuilta poimittua tekstisisältöä.
Ne soveltuvat erityisesti laajamittaiseen tekstianalyysiin ja luonnollisen kielen käsittelyyn.
WET-aineistosta voidaan esimerkiksi etsiä tiettyjen yritysten nimiä, tutkia eri aiheiden esiintymistä tai muodostaa tekstikorpuksia koneoppimisen tarpeisiin.
Tekstin poimiminen HTML-sivuilta ei kuitenkaan ole täydellinen prosessi. Osa sisällöstä voi jäädä pois, ja mukana voi olla myös navigaatioelementtien tai muiden sivurakenteiden tekstiä.
Common Crawl ja tekoäly – miksi yhteys on niin merkittävä?
Common Crawlin merkitys kasvoi voimakkaasti, kun suurten kielimallien kehittäminen alkoi vaatia yhä suurempia tekstiaineistoja.
ChatGPT:n kaltaisten tekoälypalveluiden taustalla olevat kielimallit oppivat kielen rakenteita, käsitteiden välisiä yhteyksiä ja erilaisia tietoja laajoista koulutusaineistoista.
Verkkosivuilta kerätty teksti on ollut yksi tärkeä osa tällaisten mallien kehittämistä.
Common Crawlin etuna on, että aineisto on laaja, monikielinen ja avoimesti saatavilla.
Sen ansiosta myös sellaiset toimijat, joilla ei ole omaa maailmanlaajuista verkkorobottien infrastruktuuria, voivat hyödyntää suuria verkkosisältöjen aineistoja.
Mitkä tekoälymallit ovat hyödyntäneet Common Crawlia?
Common Crawlin aineistoja on hyödynnetty useiden tunnettujen kielimallien kehityksessä.
Yksi varhaisista merkittävistä esimerkeistä on Googlen vuonna 2019 esittelemän T5-kielimallin koulutusaineisto C4 eli Colossal Clean Crawled Corpus. Se muodostettiin Common Crawlin aineistosta suodattamalla ja puhdistamalla verkkotekstiä.
Myös OpenAI:n vuonna 2020 julkaistun GPT-3-mallin tutkimusraportissa Common Crawlista johdettu aineisto oli keskeinen osa koulutusdataa.
Lisäksi Common Crawl on ollut pohjana monille avoimille tekstiaineistoille, joita on käytetty kielimallien tutkimuksessa ja kehityksessä.
Mozilla Foundationin vuonna 2024 julkaisemassa selvityksessä tarkasteltiin 47 suurta kielimallia vuosilta 2019–2023. Selvityksen mukaan vähintään 64 prosenttia niistä oli koulutettu Common Crawlista johdetulla aineistolla.
Tämä kertoo aineiston historiallisesta merkityksestä tekoälykehitykselle.
Luku ei kuitenkaan tarkoita, että 64 prosenttia kaikista nykyisistä tekoälymalleista käyttäisi Common Crawlia tai että vastaava osuus yksittäisen mallin koulutusdatasta olisi peräisin siitä.
Miten Common Crawlin sisältö päätyy tekoälymalliin?
Common Crawlin aineiston käyttäminen tekoälyn kouluttamisessa ei tarkoita sitä, että kaikki arkistossa oleva teksti syötettäisiin sellaisenaan kielimallille.
Tyypillinen käsittelyketju voi sisältää seuraavia vaiheita:
- Verkkosivujen kerääminen Common Crawlin avulla.
- Tekstisisällön poimiminen kerätystä aineistosta.
- Kielentunnistus ja haluttujen kielten valinta.
- Roskasisällön, virheellisen datan ja heikkolaatuisen tekstin suodattaminen.
- Päällekkäisen tai lähes samanlaisen sisällön poistaminen.
- Aineiston yhdistäminen muihin koulutuslähteisiin.
- Kielimallin kouluttaminen käsitellyllä aineistolla.
Käsittelymenetelmät vaihtelevat huomattavasti mallien ja kehittäjien välillä.
Tämän vuoksi verkkosivun esiintyminen Common Crawlin arkistossa ei vielä todista, että kyseistä sivua olisi käytetty jonkin tietyn tekoälymallin koulutuksessa.
Vastaavasti sivuston puuttuminen Common Crawlista ei tarkoita, etteikö sen sisältö voisi päätyä tekoälyjärjestelmien käyttöön muiden aineistolähteiden kautta.
Millainen verkkosisältö selviää tekoälyn koulutusdatan suodatuksesta?
Common Crawlin keräämä verkkosisältö käy läpi useita käsittelyvaiheita ennen kuin sitä voidaan hyödyntää kielimallien koulutuksessa. Kerätystä HTML-koodista poimitaan ensin tekstisisältö, minkä jälkeen aineistosta voidaan suodattaa heikkolaatuista sisältöä, poistaa päällekkäisyyksiä ja yhdistää jäljelle jäävä aineisto muihin koulutusdatan lähteisiin.
Kaikki verkkosisältö ei selviä näistä vaiheista. Esimerkiksi JavaScriptin taakse jäävä tai sivupohjan ylimääräisten elementtien sekaan hukkuva teksti voi jäädä poimimatta. Ohut, kaavamainen ja vahvasti kaupallinen sisältö voi puolestaan karsiutua laadunvalvonnassa. Jos sama sisältö esiintyy sadoissa eri URL-osoitteissa, päällekkäisyyksien poistaminen voi vähentää sen osuutta koulutusaineistossa merkittävästi.
Vaikka sisältö läpäisisi kaikki suodatusvaiheet, sen vaikutus kielimallin koulutukseen riippuu myös siitä, kuinka paljon kyseistä aineistoa lopulta käytetään ja millaisen painoarvon se saa.
SEO:n ja GEO:n näkökulmasta keskeinen johtopäätös on, ettei pelkkä verkkosivujen määrän kasvattaminen ole välttämättä hyödyllistä. Selkeästi poimittava, omaperäinen, asiantunteva ja muista lähteistä vahvistusta saava sisältö tarjoaa paremmat lähtökohdat koulutusdatan käsittelyvaiheiden läpäisemiseen. Tämä ei kuitenkaan takaa yksittäisen sivun päätymistä kielimallin koulutukseen.
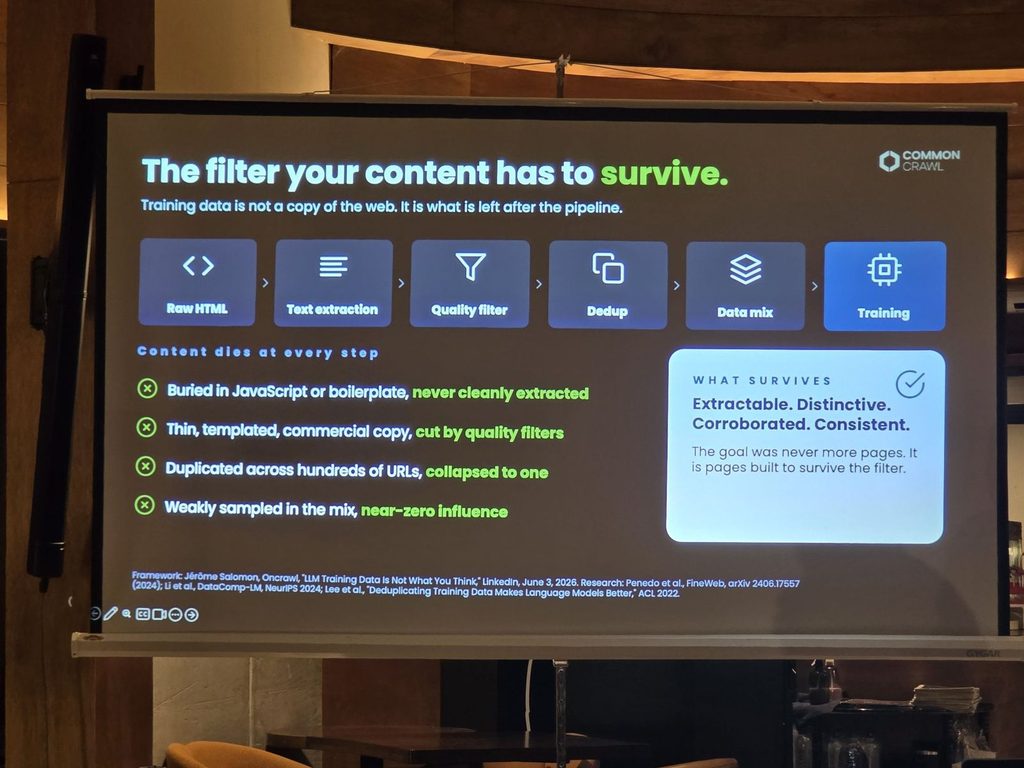
Kuva: Stephen Burns/Common Crawl / Chiang Mai SEO-konferenssin yhteydessä pidetyssä esityksessä havainnollistettu tekoälyn koulutusaineiston käsittelyketju. Verkkosivun HTML-sisällöstä edetään tekstin poiminnan, laadun suodatuksen, päällekkäisyyksien poistamisen ja aineistojen yhdistämisen kautta mallin koulutukseen.
PageRank ja Harmonic Centrality – miten verkkosivuston sijainti internetin linkkiverkostossa vaikuttaa Common Crawlin indeksointiin?
Common Crawlin verkkosivujen keräämisessä yksi kiinnostavimmista tekijöistä on verkkosivuston sijainti internetin linkkiverkostossa. Kaikki verkkosivustot eivät ole verkoston näkökulmasta samanarvoisia, eikä niiden keräämiseen käytetä yhtä paljon resursseja. Sivuston linkkiverkostollinen asema voi vaikuttaa siihen, kuinka todennäköisesti Common Crawlin verkkorobotti löytää sen ja kuinka laajasti sen sivuja kerätään.
Tämän ymmärtämiseksi on hyödyllistä tuntea kaksi verkkotunnusten analysoinnissa käytettävää mittaria: PageRank ja Harmonic Centrality.
PageRank mittaa verkkosivun suosiota ja merkittävyyttä SEOn näkökulmasta. Se perustuu ajatukseen, että verkkosivulle osoittavat linkit välittävät sille arvoa. Linkkien määrän lisäksi olennaista on se, kuinka merkittäviä linkittävät sivut itse ovat. Siksi muutama linkki vahvoilta verkkosivuilta voi olla PageRankin näkökulmasta arvokkaampi kuin suuri määrä linkkejä heikoilta sivuilta.
Harmonic Centrality eli harmoninen keskeisyys puolestaan kuvaa verkkosivuston läheisyyttä internetin keskustaan. Mittari perustuu lyhimpiin linkkipolkuihin verkkograafin solmujen välillä. Mitä lyhyempien linkkipolkujen päässä sivusto sijaitsee muista verkoston solmuista, sitä suurempi sen harmoninen keskeisyys voi olla. Eli suomeksi sanottuna, et tarvitse määrällisesti paljon linkkejä, kuten PageRankin osalta, vaan tarvitset linkityksiä mahdollisimman korkean auktoriteetin sivustoilla, jos haluat, että Common Crawl indeksoi sivustoasi mahdollisimman paljon.
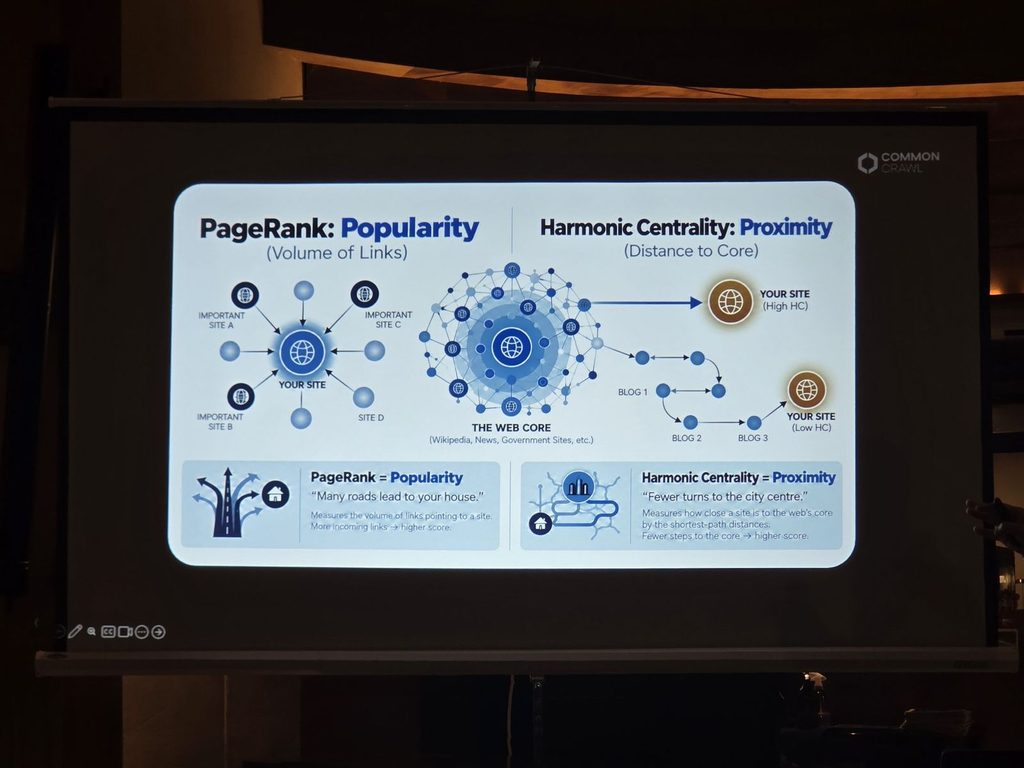
Kuva: Stephen Burnsin (Common Crawl) Chiang Mai SEO konferenssiesityksessä havainnollistettu PageRankin ja Harmonic Centralityn ero. PageRank kuvaa linkkiverkoston kautta välittyvää merkittävyyttä, kun taas Harmonic Centrality tarkastelee solmun etäisyyttä verkoston muihin osiin.
Internetin ytimellä tarkoitetaan tässä yhteydessä verkoston tiheästi linkittynyttä ja keskeistä osaa. Siihen kuuluu esimerkiksi tunnettuja uutismedioita, Wikipedia, yliopistojen verkkosivustoja ja muita laajasti verkottuneita sivustoja.
Common Crawlin näkökulmasta harmoninen keskeisyys on kiinnostava erityisesti siksi, että se voi auttaa arvioimaan verkkosivustojen löydettävyyttä ja merkitystä verkkograafissa. Korkean harmonisen keskeisyyden sivusto sijaitsee lähellä muuta verkostoa, kun taas matalan keskeisyyden sivusto voi olla useiden linkkiaskeleiden päässä verkoston keskeisistä osista.
Common Crawlin konferenssiesityksessä harmoninen keskeisyys nostettiin esiin juuri tämän eron havainnollistamiseksi. Julkisen tiedon perusteella ei kuitenkaan voida yksiselitteisesti vahvistaa, kuinka suurella painoarvolla Common Crawl käyttää kyseistä mittaria kerättävien sivustojen valinnassa tai yksittäisen sivuston keräyslaajuuden määrittämisessä.
Miksi linkit läheltä internetin ydintä ovat tärkeitä?
Otetaan esimerkiksi kaksi verkkosivustoa.
Ensimmäinen sivusto saa sata linkkiä pieniltä blogeilta, jotka sijaitsevat kaukana internetin keskeisestä linkkiverkostosta. Toinen sivusto saa vain viisi linkkiä, mutta ne tulevat tunnetuilta ja verkostossa keskeisesti sijaitsevilta verkkosivustoilta.
Vaikka ensimmäisellä sivustolla on huomattavasti enemmän ulkoisia linkkejä, toinen sivusto voi sijaita paljon lähempänä internetin ydintä.
Tämä on olennaista, koska verkkorobotit löytävät uusia verkkosivuja muun muassa seuraamalla hyperlinkkejä. Keskeisiltä sivustoilta tulevat linkit voivat muodostaa lyhyempiä reittejä muualta verkosta uudelle sivustolle ja parantaa sen mahdollisuuksia tulla löydetyksi.
Linkkien rakentamisen kannalta tämä tarkoittaa, että linkkien lukumäärän lisäksi kannattaa kiinnittää huomiota siihen, kuinka lähellä internetin keskeistä linkkiverkostoa linkittävät sivustot sijaitsevat.
Tavoitteena ei siis ole vain hankkia mahdollisimman paljon linkkejä, vaan rakentaa yhteyksiä verkkosivustoihin, joilla itsellään on vahvat yhteydet muuhun verkkoon.
On kuitenkin tärkeää erottaa kaksi asiaa toisistaan: linkkiverkoston perusteella arvioitu löydettävyys ja Common Crawlin todelliset keräysvalinnat. Sivuston harmoninen keskeisyys ei yksin takaa, että Common Crawl kerää sen sisältöä tai että sivustolta kerätään suuri määrä URL-osoitteita. Keräykseen vaikuttavat myös muut tekniset ja toiminnalliset tekijät.
Mitä tämä tarkoittaa SEO:n ja GEO:n kannalta?
Perinteisessä hakukoneoptimoinnissa laadukkaiden ulkoisten linkkien hankkiminen on tärkeä osa verkkosivuston auktoriteetin kehittämistä. Common Crawlin näkökulma tuo linkkien rakentamiseen toisenkin kiinnostavan ulottuvuuden.
Jos yrityksen verkkosivusto sijaitsee lähellä internetin keskeistä linkkiverkostoa, se voi olla helpommin erilaisten verkkorobottien löydettävissä. Tämä voi parantaa edellytyksiä sille, että sivuston sisältöä päätyy myös laajoihin verkkodatan keräysaineistoihin.
Koska Common Crawlin aineistoja hyödynnetään tekoälymallien koulutuksessa, linkkiverkoston rakenteella voi olla välillistä merkitystä myös tekoälyoptimoinnissa.
Tämä ei kuitenkaan tarkoita, että korkea Harmonic Centrality automaattisesti parantaisi näkyvyyttä ChatGPT:n tai muiden tekoälypalveluiden vastauksissa. Sisällön on ensin päädyttävä keräysaineistoon, selvittävä mahdolliset laadun ja päällekkäisyyksien suodatusvaiheet sekä tultava valituksi mallin koulutukseen.
SEO:n ja GEO:n yhteinen johtopäätös on, että linkkien rakentamisessa kannattaa tavoitella laadukkaita, aiheeseen liittyviä ja internetin linkkiverkostossa keskeisesti sijaitsevia sivustoja. Tällaiset linkit voivat tukea sekä perinteistä hakukonenäkyvyyttä että sisällön koneellista löydettävyyttä.
Mikä merkitys Common Crawlilla on hakukoneoptimoinnille?
Common Crawl ei ole hakukone eikä sen keräysaineisto ole sama asia kuin Googlen hakemisto.
Se on kuitenkin kiinnostava työkalu hakukoneoptimoinnin näkökulmasta, koska se sisältää laajasti tietoa verkkosivuista ja niiden välisistä yhteyksistä.
SEO-asiantuntija voi hyödyntää Common Crawlin aineistoa esimerkiksi verkkosivustojen löydettävyyden, linkitysten ja sisältöjen tutkimiseen.
Verkkosivustojen löydettävyys
Jos verkkosivusto löytyy Common Crawlin aineistosta, voidaan todeta, että Common Crawlin järjestelmä on onnistunut löytämään ja keräämään ainakin osan sen sisällöstä.
Tämä on yksi havainto verkkosivuston koneellisesta saavutettavuudesta.
Se ei kuitenkaan tarkoita automaattisesti sitä, että Google olisi indeksoinut sivun tai että sivu sijoittuisi hyvin hakutuloksissa.
Vastaavasti Common Crawl -aineistosta puuttuminen ei yksin osoita verkkosivuston teknistä ongelmaa.
Linkkiverkostojen tutkiminen
Common Crawl julkaisee myös verkkograafeja eli aineistoja, jotka kuvaavat verkkosivustojen välisiä hyperlinkkiyhteyksiä.
Niiden avulla voidaan tutkia esimerkiksi sitä, miten eri verkkotunnukset linkittyvät toisiinsa ja millaisia rakenteita internetin linkkiverkosto muodostaa.
Tällaisella aineistolla on kiinnostavia käyttökohteita myös linkkien rakentamisessa ja kilpailija-analyysissä.
Linkkidatasta voidaan esimerkiksi tutkia, millaiset sivustot muodostavat tietyn toimialan verkoston ja miten eri aihepiirien verkkosivustot liittyvät toisiinsa.
Common Crawl ei kuitenkaan tarjoa samanlaista valmista SEO-analytiikkapalvelua kuin Ahrefs tai Semrush. Aineiston hyödyntäminen vaatii usein teknistä osaamista, ohjelmointia ja datan jatkokäsittelyä.
Sisältöjen ja kilpailijoiden analysointi
Common Crawlin avulla voidaan tutkia laajasti myös eri aiheista julkaistua verkkosisältöä.
Aineistosta voidaan esimerkiksi selvittää, millaisia termejä tietyllä toimialalla käytetään, miten yritykset kuvaavat tuotteitaan ja millaisia käsitteitä eri verkkosivustoilla esiintyy.
Tällainen analyysi voi auttaa tunnistamaan aihealueita, sisältöjen välisiä yhteyksiä ja toimialalla vakiintunutta terminologiaa.
On kuitenkin huomioitava, että aineisto sisältää vain kerättyjä sivuja ja niiden keräyshetken mukaisia versioita.
Siksi Common Crawl ei yksin sovellu reaaliaikaiseen kilpailijaseurantaan.
Common Crawl ja tekoälyoptimointi GEO – miten verkkosisältö vaikuttaa tekoälyn käsitykseen yrityksestä?
Tekoälyoptimoinnin eli GEO:n (Generative Engine Optimization) tavoitteena on parantaa yrityksen, brändin, tuotteiden tai palveluiden näkyvyyttä ja oikeaa esittämistä tekoälypohjaisissa hakupalveluissa ja vastauksissa.
Common Crawl on GEO:n kannalta kiinnostava, koska se havainnollistaa yhtä tapaa, jolla internetissä julkaistu tieto voi päätyä kielimallien koulutusaineistoihin.
Tekoälymallin koulutusvaiheessa malli voi oppia eri käsitteiden, yritysten, tuotteiden ja aiheiden välisiä yhteyksiä.
Jos yrityksestä julkaistaan johdonmukaista tietoa useilla luotettavilla verkkosivustoilla, samaan yritykseen liittyvät käsitteet voivat esiintyä koulutusaineistoissa toistuvasti.
Tämä voi osaltaan vaikuttaa siihen, millaisia yhteyksiä kielimalli oppii muodostamaan.
GEO:n kannalta olennaista ei siis ole pelkästään se, mitä yritys kertoo itsestään omilla verkkosivuillaan, vaan myös se, mitä yrityksestä kerrotaan muualla internetissä.
Brändimaininnat ja tekoälyn muodostama käsitys
Perinteisessä hakukoneoptimoinnissa ulkoiset linkit ovat pitkään olleet yksi keskeisistä verkkosivuston tunnettuuteen ja auktoriteettiin liittyvistä tekijöistä.
Tekoälyoptimoinnissa tarkastelu on laajempi.
Myös yrityksen nimen esiintyminen tekstissä ilman hyperlinkkiä voi olla kiinnostavaa, koska kielimallien koulutuksessa hyödynnetään tekstin sisältämiä käsitteellisiä yhteyksiä.
Otetaan esimerkiksi suomalainen yritys, joka valmistaa teollisuuden pakkausmateriaaleja.
Jos yrityksen nimi esiintyy useilla alan verkkosivustoilla samassa yhteydessä esimerkiksi elintarvikepakkausten, vastuullisten materiaalien ja kotimaisen valmistuksen kanssa, nämä käsitteet voivat muodostaa toistuvia yhteyksiä verkkotekstissä.
Kielimalli voi koulutuksen aikana oppia tällaisia yhteyksiä, jos kyseinen aineisto päätyy koulutukseen ja saa siinä riittävästi painoarvoa.
Tämä ei kuitenkaan tarkoita, että yksittäinen brändimaininta automaattisesti parantaisi yrityksen näkyvyyttä ChatGPT:ssä tai muussa tekoälypalvelussa.
Kielimallien koulutusprosesseja, aineistojen painotuksia ja vastausten muodostumista ei yleensä tunneta niin tarkasti, että yksittäisen maininnan vaikutusta voitaisiin luotettavasti mitata.
Konsensus ja tiedon johdonmukaisuus
Yksi tekoälyoptimoinnin kiinnostavimmista näkökulmista liittyy siihen, kuinka johdonmukaisesti yrityksestä kerrotaan eri lähteissä.
Jos yrityksen toimiala, tuotteet, erityisosaaminen ja muut keskeiset tiedot esiintyvät useissa toisistaan riippumattomissa lähteissä, verkkoon muodostuu yhtenäisempi tietopohja.
Tätä voidaan kuvata konsensuksen rakentamiseksi.
Konsensus ei tässä yhteydessä tarkoita yksittäistä tekoälymallin käyttämää virallista sijoitustekijää. Kyse on siitä, että eri lähteissä toistuva ja keskenään yhdenmukainen tieto voi auttaa muodostamaan selkeämmän käsityksen tietystä yrityksestä tai aiheesta.
Käytännössä yrityksen kannattaa huolehtia siitä, että sen keskeiset tiedot ovat oikein sekä omilla verkkosivuilla että muualla julkaistuissa sisällöissä.
Erityisesti asiantuntevat artikkelit, toimialajulkaisut, uutiset ja muut uskottavat lähteet voivat olla hyödyllisiä yrityksen tunnettuuden ja digitaalisen näkyvyyden kehittämisessä.
Miksi pelkkä Common Crawliin pääseminen ei riitä?
Common Crawl on yksi mahdollinen aineistolähde tekoälymallien koulutuksessa, mutta sen merkitystä ei pidä tulkita liian suoraviivaisesti.
Tekoälypalvelut voivat hyödyntää tietoa useilla eri tavoilla.
Osa tiedosta voi olla peräisin mallin aikaisemmasta koulutuksesta. Osa puolestaan voidaan hakea ajantasaisista verkkolähteistä vasta käyttäjän esittämän kysymyksen yhteydessä.
Tällainen hakua hyödyntävä vastausten muodostaminen tunnetaan usein nimellä RAG eli Retrieval-Augmented Generation.
Esimerkiksi ChatGPT:n verkkohakua hyödyntävä vastaus ei edellytä, että kaikki siinä käytetyt verkkosivut olisivat aikaisemmin olleet Common Crawlin aineistossa.
Tämän vuoksi GEO-strategian ei pidä perustua vain yhden verkkorobotin tai aineistoarkiston huomioimiseen.
Laajempi tavoite on varmistaa, että yrityksestä on saatavilla laadukasta, ajantasaista ja helposti löydettävää tietoa useista relevanteista lähteistä.
Miten Common Crawl eroaa Googlesta ja muista verkkoroboteista?
Common Crawlin ja Googlen toiminnassa on teknisiä yhtäläisyyksiä, mutta niiden tarkoitukset ovat erilaiset.
Googlebot kerää verkkosivuja Googlen hakujärjestelmiä varten. Common Crawlin CCBot puolestaan kerää verkkosisältöä avoimeen aineistoarkistoon.
Myös tekoälypalveluiden omilla verkkoroboteilla voi olla erilaisia käyttötarkoituksia.
| Järjestelmä | Ensisijainen tarkoitus |
|---|---|
| Common Crawl / CCBot | Verkkosisällön kerääminen avoimeen aineistoarkistoon |
| Googlebot | Verkkosivujen kerääminen Googlen hakujärjestelmiä varten |
| Bingbot | Verkkosivujen kerääminen Bingin hakujärjestelmiä varten |
| GPTBot | Verkkosisällön kerääminen OpenAI:n mallien kehittämiseen |
| OAI-SearchBot | Verkkosivujen löytäminen OpenAI:n hakutoimintoja varten |
| ClaudeBot | Verkkosisällön kerääminen Anthropicin tekoälymallien kehittämiseen |
Eri verkkorobottien salliminen tai estäminen voi siis vaikuttaa erilaisiin käyttötarkoituksiin.
On myös hyvä huomata, ettei yksittäisen robotin pääsy sivustolle takaa näkyvyyttä kyseisen yrityksen hakutuloksissa tai tekoälyvastauksissa.
Miten tarkistan, löytyykö oma verkkosivustoni Common Crawlista?
Common Crawl tarjoaa julkisen indeksin, jonka avulla voidaan etsiä tietoja kerätyistä URL-osoitteista.
Indeksi tunnetaan nimellä Common Crawl Index, ja sitä voidaan käyttää esimerkiksi verkkosivuston yksittäisten osoitteiden tai laajempien URL-joukkojen tutkimiseen.
Yksi tapa aloittaa on käyttää Common Crawlin indeksipalvelua osoitteessa:
Palvelusta voidaan selvittää, onko tietty verkkosivu löytynyt jostakin valitusta keräysaineistosta.
Mitä indeksistä voi nähdä?
Indeksitiedoista voidaan saada selville esimerkiksi verkkosivun osoite, keräysajankohta, HTTP-vastauskoodi sekä viittaus siihen arkistotiedostoon, johon sivun keräystallenne on sijoitettu.
Tietojen perusteella voidaan myös hakea varsinaista tallennettua sisältöä.
Tämä mahdollistaa esimerkiksi sen tutkimisen, millainen verkkosivun sisältö oli Common Crawlin käytettävissä tiettynä ajankohtana.
Mitä jos omaa sivustoa ei löydy?
Jos verkkosivusto ei löydy tietystä Common Crawlin indeksistä, siitä ei vielä voi päätellä, että sivustossa olisi ongelma.
Mahdollisia syitä ovat esimerkiksi se, ettei verkkorobotti ole löytänyt sivua, sivua ei ole valittu kerättäväksi tai sen hakeminen ei ole onnistunut.
Myös verkkosivuston robots.txt-asetukset tai palvelimen suojausratkaisut voivat vaikuttaa keräämiseen.
Lisäksi on muistettava, että Common Crawl julkaisee erillisiä keräysaineistoja. Sivusto voi esiintyä yhdessä keräyksessä mutta puuttua toisesta.
Siksi luotettava tarkastelu kannattaa tehdä useammasta keräysaineistosta.
Miten Common Crawlin CCBot-verkkorobottia voi hallita?
Verkkosivuston ylläpitäjä voi vaikuttaa CCBotin pääsyyn sivustolle robots.txt-tiedoston avulla. Lisäksi palomuuriasetuksilla voidaan palvelintasolla estää CCBotin vierailut. Eli jos robots.txt-tiedostossa bottia ei ole estetty, mutta estot ovat palomuurissa, ei botti pääse lukemaan sivuja.
Robots.txt on verkkosivuston juurihakemistossa sijaitseva tiedosto, jossa voidaan antaa verkkoroboteille ohjeita sivuston keräämisestä.
Jos verkkosivuston ylläpitäjä haluaa estää CCBotin pääsyn koko sivustolle, robots.txt-tiedostoon voidaan lisätä seuraava määritys:
User-agent: CCBot
Disallow: /
Tämä ohje kieltää CCBotia keräämästä sivuston sisältöä.
Jos taas sivuston sisältö halutaan sallia CCBotille eikä muu robots.txt-tiedoston sääntö rajoita sitä, voidaan käyttää esimerkiksi seuraavaa määritystä:
User-agent: CCBot
Allow: /
Robots.txt on kuitenkin verkkoroboteille tarkoitettu ohjeistus, ei tekninen pääsynesto. Sen noudattaminen riippuu robotin toiminnasta.
Lisäksi robots.txt-tiedoston muuttaminen ei automaattisesti poista aikaisemmin kerättyä sisältöä Common Crawlin arkistosta.
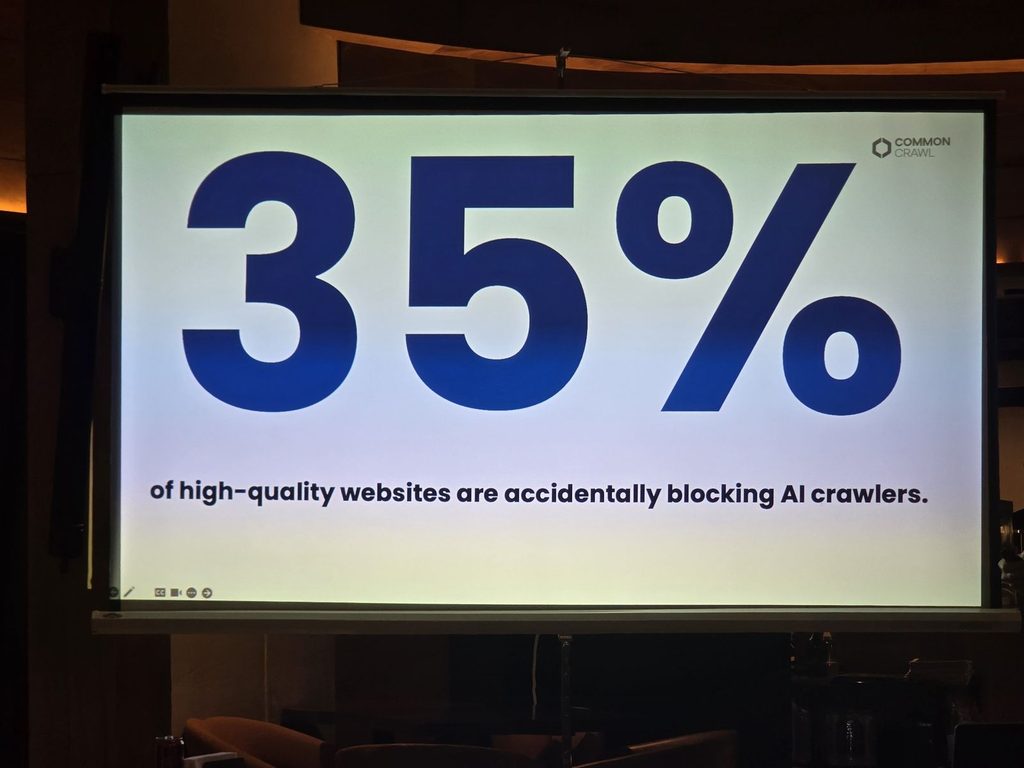
Kuva: Common Crawlin Shephen Burns piti tietoiskun 2026 marraskuussa Chiang Mai SEO konferenssin yhteydessä ja Common Crawlin mukaan 35 % ”korkealaatuisista nettisivustoista” estää vahingossa AI-crawlereiden pääsyn sivustolle. Tarkista siis, että omalla sivustollasi asiat on kunnossa!
Kannattaako CCBot sallia vai estää?
Hakukoneoptimoinnin ja tekoälyoptimoinnin näkökulmasta CCBotin estämiseen ei yleensä ole syytä ryhtyä pelkästään näkyvyyden parantamiseksi.
Jos yritys haluaa verkkosisältönsä olevan mahdollisimman laajasti löydettävissä ja hyödynnettävissä, CCBotin salliminen voi olla perusteltua.
Toisaalta kaikilla verkkosivustoilla ei ole samanlaisia tavoitteita.
Esimerkiksi maksullista sisältöä julkaiseva media, tietokannan omistaja tai aineistonsa tekoälykoulutuskäyttöä rajoittava organisaatio voi suhtautua verkkorobottien toimintaan eri tavalla.
Päätöksessä kannattaa huomioida liiketoiminnalliset tavoitteet, tekijänoikeudet ja sisällön käyttöön liittyvät ehdot.
CCBotin salliminen ei myöskään ole edellytys Googlen hakukonenäkyvyydelle.
Voiko Common Crawliin ilmoittaa oman verkkosivuston?
Common Crawl ei ole perinteinen hakukone, johon verkkosivusto lisätään esimerkiksi Google Search Consolen kaltaisella työkalulla.
Verkkosivuston löytyminen perustuu Common Crawlin omiin keräysmenetelmiin ja sivuston saavutettavuuteen.
Ylläpitäjä voi kuitenkin parantaa verkkosivuston yleistä koneellista löydettävyyttä huolehtimalla teknisestä toteutuksesta.
Tärkeitä asioita ovat esimerkiksi toimivat sisäiset linkit, selkeä sivustorakenne, palvelimelta saatava HTML-sisältö sekä se, ettei verkkorobottien pääsyä rajoiteta tarpeettomasti.
Myös muilta verkkosivustoilta tulevat linkit voivat auttaa verkkosivujen löytämisessä.
Näiden toimenpiteiden vaikutusta Common Crawlin keräysvalintoihin ei kuitenkaan voi taata.
Common Crawlin rajoitukset ja ongelmat
Vaikka Common Crawl on arvokas aineistolähde, siihen liittyy useita rajoituksia, jotka on tärkeää ymmärtää.
Aineisto ei kata koko internetiä
Common Crawl kerää vain osan julkisesta verkosta.
Aineistosta puuttuu esimerkiksi suuri määrä kirjautumista vaativaa sisältöä sekä sivuja, joita verkkorobotti ei löydä tai pysty hakemaan.
Myös eri kielten ja alueiden edustus voi vaihdella.
Tästä syystä Common Crawl ei anna täydellistä kuvaa internetin sisällöstä.
Kerätty sisältö voi olla vanhentunutta
Common Crawlin aineisto kuvaa verkkosivuja niiden keräyshetkellä.
Jos verkkosivun sisältö muuttuu myöhemmin, aikaisempi arkistotallenne ei muutu sen mukana.
Tämä on erityisen tärkeää yritysten tietojen kannalta.
Esimerkiksi vanhentuneet tuotekuvaukset, yhteystiedot tai palveluvalikoimaa koskevat tiedot voivat jäädä aikaisempiin keräysaineistoihin.
Aineistossa voi olla virheellistä tietoa
Common Crawl kerää verkkosisältöä, mutta se ei tarkoita, että kaikki kerätty tieto olisi luotettavaa.
Internetissä julkaistaan virheellisiä väitteitä, vanhentunutta tietoa, mainossisältöä ja tarkoituksellista disinformaatiota.
Siksi aineistoa hyödyntävien tutkijoiden ja tekoälykehittäjien on arvioitava sen laatua.
Tekijänoikeudet ja henkilötiedot
Verkkosivun julkinen saatavuus ei tarkoita automaattisesti sitä, että sen sisältöä saisi käyttää rajoituksetta mihin tahansa tarkoitukseen.
Common Crawlin avoin saatavuus ja sen sisältämän materiaalin tekijänoikeudellinen asema ovat eri asioita.
Aineisto voi sisältää tekijänoikeudella suojattua materiaalia ja henkilötietoja.
Aineiston käyttäjän on siksi huomioitava sovellettava lainsäädäntö, käyttötarkoitus ja mahdolliset oikeudelliset rajoitukset.
Erityisesti tekoälyn koulutusaineistoihin liittyvät tekijänoikeudelliset kysymykset ovat olleet laajan oikeudellisen ja yhteiskunnallisen keskustelun kohteena.
Miten yrityksen kannattaa huomioida Common Crawl SEO- ja GEO-strategiassaan?
Common Crawl ei ole yksittäinen näkyvyyskanava, jota varten kannattaisi rakentaa kokonaan erillinen sisältöstrategia.
Sen merkitys liittyy laajempaan kysymykseen siitä, miten yrityksestä julkaistu tieto on koneellisesti löydettävissä, ymmärrettävissä ja hyödynnettävissä.
Yrityksen kannattaa kiinnittää huomiota erityisesti seuraaviin asioihin.
1. Julkaise asiantuntevaa ja helposti käsiteltävää sisältöä
Verkkosivuston tärkeimmän sisällön kannattaa olla saatavilla selkeässä HTML-muodossa.
Olennaisten tietojen piilottaminen vaikeasti käsiteltävien käyttöliittymäelementtien tai pelkästään JavaScriptin avulla tuotettujen näkymien taakse voi vaikeuttaa joidenkin verkkorobottien toimintaa.
Sisällön kannattaa myös vastata selkeästi käyttäjien kysymyksiin.
Esimerkiksi palvelun määritelmä, käyttötarkoitus, hyödyt ja keskeiset ominaisuudet on hyvä kuvata ymmärrettävästi.
2. Rakenna yritykselle johdonmukainen digitaalinen identiteetti
Yrityksen nimen, palveluiden, toimialan ja muiden keskeisten tietojen tulisi olla yhdenmukaisia eri verkkosivustoilla.
Tämä helpottaa sekä ihmisiä että erilaisia tietojärjestelmiä yhdistämään yritykseen liittyviä tietoja.
Erityisesti tekoälyoptimoinnissa on hyödyllistä tarkastella sitä, millaisissa asiayhteyksissä yrityksen nimi esiintyy.
3. Kehitä näkyvyyttä myös oman verkkosivuston ulkopuolella
Yrityksen omat verkkosivut ovat vain yksi osa internetissä julkaistua tietoa.
Ulkopuoliset asiantuntija-artikkelit, uutiset, toimialajulkaisut ja muut relevantit verkkolähteet voivat vahvistaa yrityksen tunnettuutta ja tuoda sen osaksi laajempaa aiheeseen liittyvää tietoverkostoa.
Tässä yhdistyvät perinteinen digitaalinen PR, linkkien rakentaminen ja tekoälyoptimointi.
Pelkkä mahdollisimman suuri brändimainintojen määrä ei kuitenkaan ole järkevä tavoite.
Julkaisujen laadulla, asiayhteydellä, uskottavuudella ja kohdeyleisöllä on merkitystä.
4. Huolehdi verkkosivuston teknisestä saavutettavuudesta
Verkkosivuston tekninen hakukoneoptimointi auttaa myös muita verkkorobotteja löytämään ja käsittelemään sisältöä.
Erityistä huomiota kannattaa kiinnittää sivuston rakenteeseen, sisäisiin linkkeihin, HTTP-vastauskoodeihin, uudelleenohjauksiin ja robots.txt-asetuksiin.
On kuitenkin muistettava, että eri verkkorobotit käsittelevät verkkosivuja eri tavoilla.
5. Seuraa tekoälynäkyvyyttä laajemmin kuin yhden aineistolähteen kautta
Common Crawl -esiintymistä voi tutkia osana teknistä analyysiä, mutta yrityksen GEO-tuloksia ei kannata mitata pelkästään sen perusteella.
Käytännössä hyödyllisempiä mittareita voivat olla esimerkiksi yrityksen esiintyminen tekoälyvastauksissa, kilpailijoihin suhteutettu näkyvyys, verkkosivustolle tuleva liikenne sekä tekoälypalveluista syntyvät yhteydenotot ja myynti.
Näkyvyyttä kannattaa arvioida myös laadullisesti: esitetäänkö yrityksen palvelut oikein ja millaisiin kysymyksiin yritys yhdistetään?
Common Crawlin tulevaisuus
Common Crawlin merkitys liittyy yhä vahvemmin tekoälyn kehitykseen.
Avoimien verkkodatasetien tarve ei ole kadonnut, vaikka suuret teknologiayhtiöt kehittävät omia tiedonkeruujärjestelmiään ja hyödyntävät myös lisensoituja aineistoja.
Päinvastoin avoimella datalla voi olla tärkeä rooli tekoälytutkimuksessa, monikielisten mallien kehittämisessä ja pienempien toimijoiden mahdollisuuksissa rakentaa omia tekoälyratkaisujaan.
Common Crawl on myös kehittänyt verkkograafeihin perustuvia aineistoja ja uusia tapoja hyödyntää kerättyä dataa.
Esimerkiksi vuonna 2026 organisaatio julkaisi kokeellisen verkkograafien vektoriesityksiin perustuvan aineiston, joka sisälsi tietoja kymmenistä miljoonista verkkopalvelinten isäntänimistä.
Tällaiset aineistot avaavat mahdollisuuksia tutkia verkkosivustojen välisiä suhteita myös koneoppimisen menetelmillä.
Samalla avoimen verkkodatan käyttöön liittyvät kysymykset tulevat todennäköisesti säilymään ajankohtaisina.
Keskeisiä kysymyksiä ovat muun muassa aineiston laatu, eri kielten edustus, tekijänoikeudet ja verkkosivustojen ylläpitäjien mahdollisuudet vaikuttaa sisältönsä käyttöön.
Yhteenveto: miksi Common Crawl kannattaa tuntea?
Common Crawl on yksi internetin tärkeimmistä avoimista verkkodatan lähteistä. Se kerää miljardien verkkosivujen sisältöä ja tarjoaa aineistoa tutkijoiden, yritysten ja tekoälykehittäjien käyttöön.
Sen merkitys ei rajoitu verkkosivujen arkistointiin, sillä Common Crawlista johdettuja aineistoja on käytetty monien merkittävien kielimallien koulutuksessa.
Hakukoneoptimoinnin ja tekoälyoptimoinnin näkökulmasta Common Crawl havainnollistaa sitä, kuinka verkkosivujen sisältö, yritysten nimet, aihealueet ja verkkosivustojen väliset yhteydet voivat päätyä osaksi laajempia tietoaineistoja.
Yrityksen kannalta tärkein johtopäätös on, että digitaalinen näkyvyys ei rakennu pelkästään omien verkkosivujen varaan.
Laadukas sisältö, teknisesti toimiva verkkosivusto ja johdonmukainen näkyvyys luotettavissa ulkopuolisissa lähteissä muodostavat perustan sekä perinteiselle hakukoneoptimoinnille että tekoälyoptimoinnille.
Common Crawliin pääseminen ei yksin takaa näkyvyyttä tekoälyvastauksissa, mutta sen toimintaperiaatteiden ymmärtäminen auttaa hahmottamaan, miten verkossa julkaistua tietoa voidaan hyödyntää tekoälyn kehittämisessä.
eLuotsi Finland Oy auttaa yrityksiä kehittämään hakukonenäkyvyyttään ja tekoälyoptimointiaan yhdistämällä teknisen hakukoneoptimoinnin, laadukkaan sisällöntuotannon, linkkien rakentamisen ja digitaalisen PR:n.
Usein kysytyt kysymykset Common Crawlista
Onko Common Crawl hakukone?
Ei. Common Crawl kerää ja arkistoi verkkosivujen sisältöä avoimeen aineistoon, mutta se ei tarjoa Googlen kaltaista kuluttajille suunnattua hakukonetta. Sen aineistoja voidaan kuitenkin käyttää erilaisten hakujärjestelmien ja analyysipalveluiden kehittämiseen.
Käyttääkö ChatGPT Common Crawlia?
OpenAI:n GPT-3-mallin julkaistussa tutkimusraportissa Common Crawlista johdettu aineisto oli merkittävä koulutusdatan lähde. Kaikkien uudempien mallien tarkkoja koulutusaineistoja ei ole julkistettu. ChatGPT voi myös hyödyntää verkkohakua, joka on eri asia kuin Common Crawlin aineiston käyttäminen mallin koulutuksessa.
Miten saan verkkosivustoni Common Crawliin?
Common Crawliin ei ole samanlaista sivuston ilmoittamismenettelyä kuin hakukoneiden omissa työkaluissa. Sivuston kannattaa olla teknisesti saavutettava, hyvin linkitetty ja verkkorobottien käytettävissä. Tämä ei kuitenkaan takaa päätymistä keräysaineistoon.
Parantaako Common Crawliin pääseminen tekoälynäkyvyyttä?
Ei automaattisesti. Common Crawl on mahdollinen koulutusaineiston lähde, mutta yksittäisen verkkosivun esiintyminen arkistossa ei takaa sen käyttöä tekoälymallin koulutuksessa tai näkymistä tekoälyn vastauksissa.
Onko Common Crawl ilmainen?
Kyllä. Common Crawlin aineistot ovat avoimesti saatavilla maksutta. Suurten tietomäärien käsittely voi kuitenkin aiheuttaa kustannuksia esimerkiksi pilvipalveluiden laskentaresurssien tai tiedonsiirron kautta.
Voiko Common Crawlin estää robots.txt-tiedostolla?
Kyllä. CCBot-verkkorobottia voidaan ohjata robots.txt-tiedostossa. Estäminen vaikuttaa robotin tulevaan keräämiseen, mutta ei automaattisesti poista aikaisemmin arkistoitua sisältöä.
Kuinka usein Common Crawl päivittää aineistoaan?
Common Crawl julkaisee uusia keräysaineistoja yleensä noin kerran kuukaudessa. Yksittäisen verkkosivuston tai sivun esiintymistiheys voi kuitenkin vaihdella huomattavasti.
Voiko Common Crawlista tutkia kilpailijoiden linkkejä?
Kyllä, Common Crawlin verkkograafit ja keräysaineistot sisältävät tietoja verkkosivujen välisistä linkeistä. Niiden analysointi vaatii kuitenkin yleensä teknistä osaamista, eivätkä aineistot vastaa sellaisenaan kaupallisten SEO-työkalujen linkkitietokantoja.